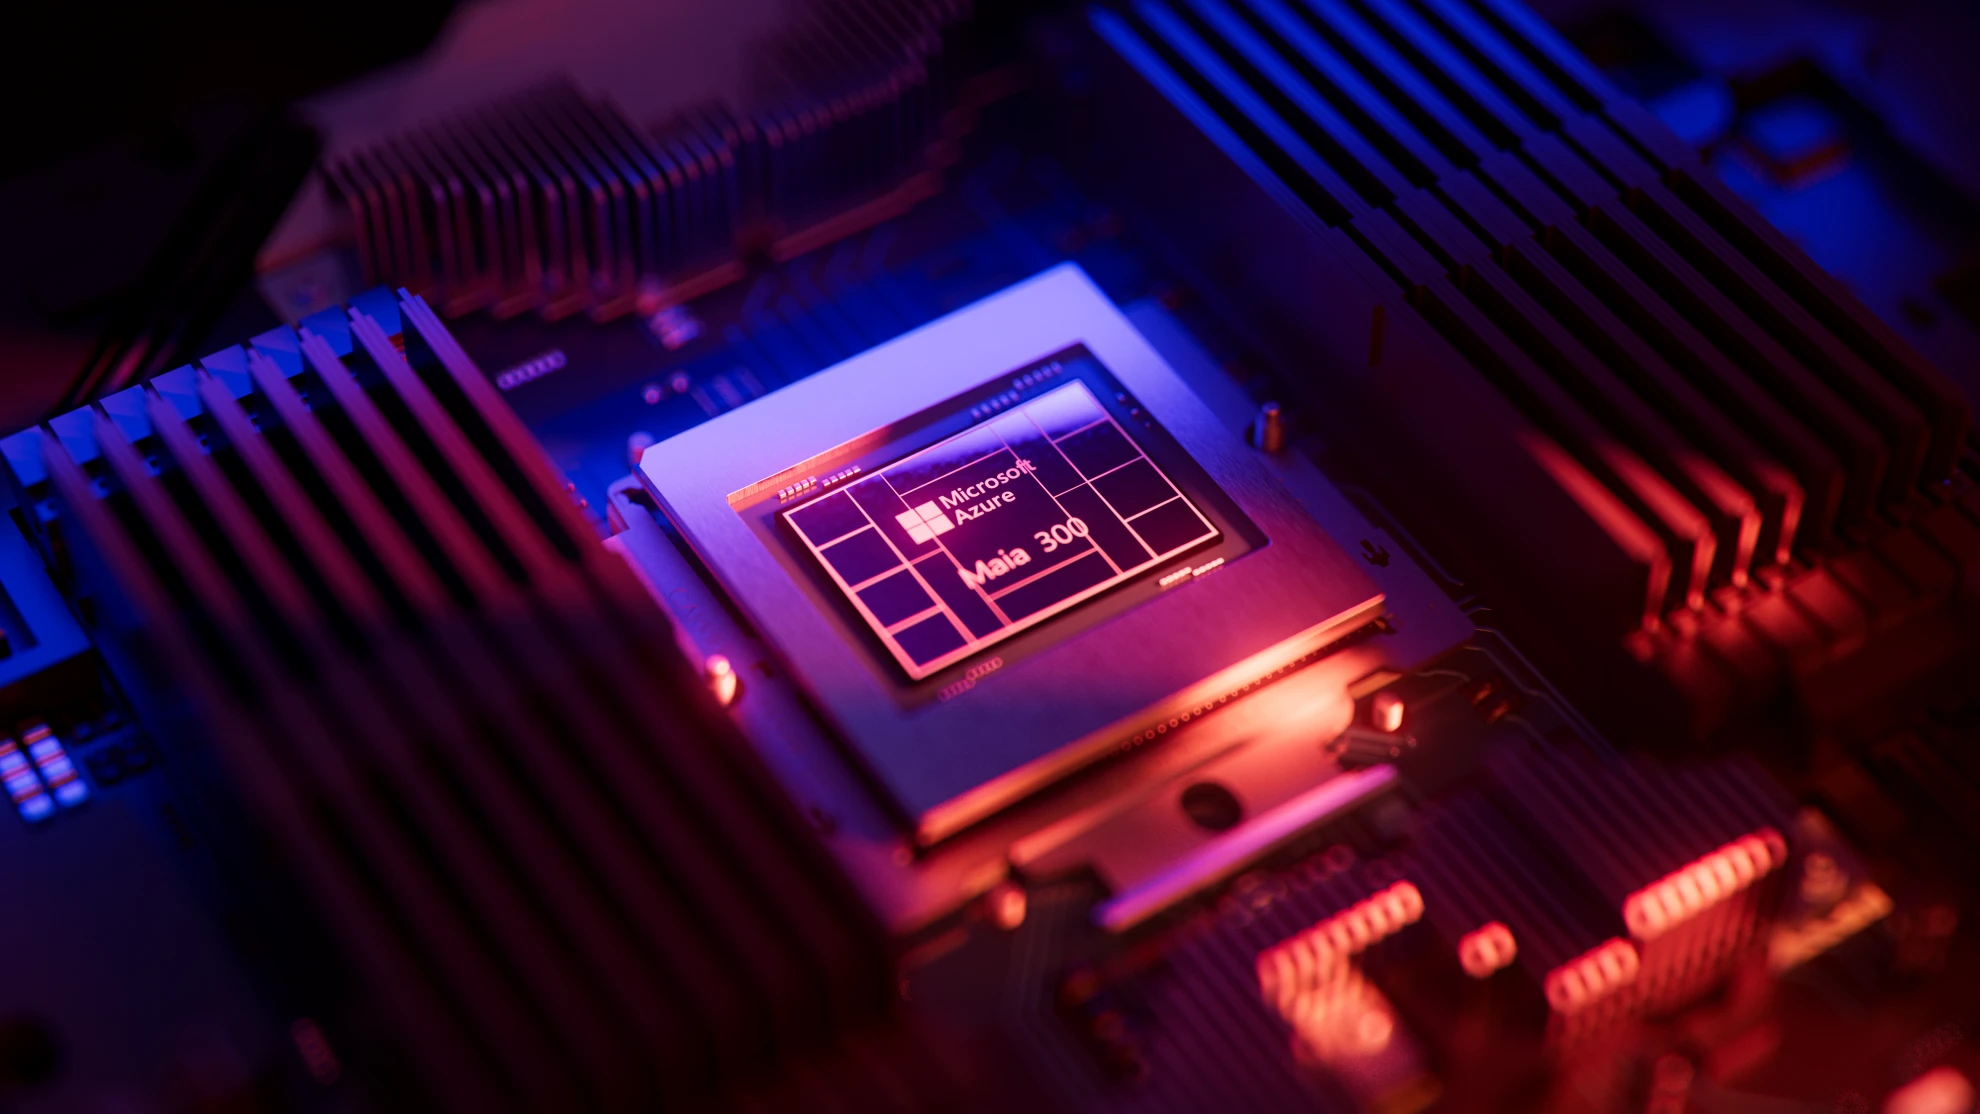
Microsoft a présenté le 12 octobre 2026 Maia 300, sa nouvelle architecture de puces destinées à l’intelligence artificielle dans Azure. Le groupe annonce un déploiement à partir de 2027 et promet une meilleure efficacité pour faire fonctionner Copilot, les agents IA et les modèles à long contexte. Il revendique notamment 40 % de tokens supplémentaires par mégawatt face à certains systèmes GPU. Ces chiffres sont des projections du constructeur et ne constituent pas encore un test indépendant.
Dernière mise à jour : 18 octobre 2026.
Ce qu’il faut retenir
- Présentation officielle le 12 octobre 2026.
- Déploiements à grande échelle annoncés à partir de 2027.
- Maia 300 est optimisé pour l’inférence IA, c’est-à-dire la génération de réponses.
- Microsoft promet 40 % de tokens supplémentaires par mégawatt face à des systèmes GPU de référence.
- Un rack de 96 accélérateurs atteindrait jusqu’à 7 fois le débit d’un rack Maia 200, selon Microsoft.
- Aucun prix de Maia 300 ni date de commercialisation pour le grand public n’ont été annoncés.
Maia 300 : pourquoi Microsoft construit ses propres puces
Les assistants IA répondent à des millions de demandes, parfois longues et complexes. Les systèmes qui calculent ces réponses consomment beaucoup d’électricité, de mémoire et de capacité réseau.
Microsoft utilise déjà Maia 200 pour certaines charges de travail, dont Copilot. Avec Maia 300, la société souhaite piloter davantage son infrastructure et adapter matériel et logiciels à ses applications réelles, au lieu de s’appuyer uniquement sur des accélérateurs généralistes.
Le projet s’inscrit dans une stratégie de maîtrise des coûts, mais ne signifie pas l’abandon des GPU Nvidia ou AMD dans Azure. Ces équipements continueront d’être utiles à d’autres tâches, notamment l’entraînement.
40 % de tokens en plus par mégawatt : que signifie le chiffre ?
Un token est une unité de texte utilisée par les modèles de langage. La mesure « tokens par mégawatt » cherche à rapporter la quantité de réponses calculées à la puissance électrique consommée.
Microsoft affirme que Maia 300 pourrait produire 40 % de tokens supplémentaires à puissance égale par rapport à des systèmes reposant sur des GPU de premier plan. Cela suggère un potentiel gain d’efficacité pour les centres de données à grande échelle.
La firme n’a toutefois pas livré, dans son annonce grand public, un ensemble complet de tests permettant de comparer tous les modèles, les GPU concurrents et les configurations. Le chiffre doit donc être présenté comme une estimation interne.
Jusqu’à sept fois le débit par rack
| Indicateur | Annonce Microsoft |
|---|---|
| Architecture | Azure Maia 300 |
| Objectif principal | Inférence IA à grande échelle |
| Mise en service à grande échelle | À partir de 2027 |
| Efficacité revendiquée | +40 % de tokens par mégawatt |
| Configuration de référence | 96 accélérateurs par rack |
| Débit revendiqué face à Maia 200 | Jusqu’à 7 fois par rack |
Le facteur sept compare des ensembles complets de serveurs, et non nécessairement une puce Maia 300 à une puce Maia 200. Le nombre d’accélérateurs et l’architecture globale du rack ont une influence majeure sur les performances.
Microsoft vise en particulier les requêtes nécessitant de longs documents en entrée, des réponses interactives et des agents capables d’enchaîner plusieurs actions. Dans ces scénarios, la circulation des données devient aussi importante que la puissance brute.
Mémoire et réseau conçus pour l’IA moderne
L’architecture repose sur plusieurs blocs de calcul et de gestion des données, reliés par un réseau interne conçu pour réduire les déplacements inutiles. Microsoft explique que des modèles très sollicités perdent du temps et de l’énergie lorsque les calculs attendent des transferts mémoire.
Les documents techniques de l’entreprise décrivent une mémoire HBM4 à haute bande passante et une interconnexion Ethernet adaptée aux grands déploiements. Ces choix visent à servir simultanément de nombreuses requêtes et à garder un temps de réponse acceptable.
Le bénéfice concret dépendra des modèles, du nombre d’utilisateurs et des optimisations logicielles. Les caractéristiques théoriques d’un composant ne préjugent pas des performances d’un service accessible aux clients.
Quel impact pour Copilot en France ?
Microsoft prévoit d’utiliser plus largement sa plateforme Maia pour ses propres services, notamment Copilot, GitHub et ses produits professionnels. Si le déploiement fonctionne comme prévu, cela pourrait aider à absorber une demande croissante sans augmenter les coûts d’infrastructure dans les mêmes proportions.
Cela ne garantit pas une baisse du prix des abonnements Microsoft 365 ou Copilot en France. L’entreprise n’a annoncé aucune nouvelle grille tarifaire liée à Maia 300.
TechPi a déjà détaillé l’enquête britannique sur Microsoft 365 et Copilot. Pour les usages hors cloud, notre guide de l’IA en local explique les avantages et contraintes d’une exécution sur PC ou Mac.
Notre avis
Maia 300 illustre le déplacement de la concurrence : les géants du cloud ne cherchent plus seulement les GPU les plus puissants, mais des systèmes complets adaptés à leurs propres usages d’inférence.
Les promesses d’efficacité sont intéressantes, surtout face aux besoins énergétiques de l’IA. Elles devront néanmoins être confrontées à des mesures reproductibles et à la réalité du déploiement en 2027.
FAQ
Quand sortira Microsoft Maia 300 ?
Microsoft annonce des déploiements à grande échelle à partir de 2027. Ce n’est pas une puce vendue directement aux particuliers.
Maia 300 est-elle plus rapide que les puces Nvidia ?
Microsoft annonce des gains d’efficacité pour certaines charges d’inférence, mais ne fournit pas une comparaison universelle et indépendante de tous les accélérateurs Nvidia.
Maia 300 rendra-t-elle Copilot moins cher en France ?
Aucune baisse de tarif Copilot n’a été annoncée à ce titre. Des gains techniques ne se traduisent pas automatiquement par une réduction du prix payé par les clients.
Quelle différence entre Maia 200 et Maia 300 ?
Maia 200 est déjà utilisé sur certaines charges de production, tandis que Maia 300 est annoncé pour 2027 avec une architecture et des racks adaptés à des volumes d’inférence plus importants.